
怎么为ai agent做长期记忆
AI长期记忆解决方案提升Agent智能
在构建AI Agent时,长期记忆(Long-Term Memory, LTM)是让Agent具备持续学习能力、个性化以及维持连贯性的核心。
一、 长期记忆 (LTM) vs 长上下文 (Long Context)
可以用计算机架构来做一个最直观的比喻:
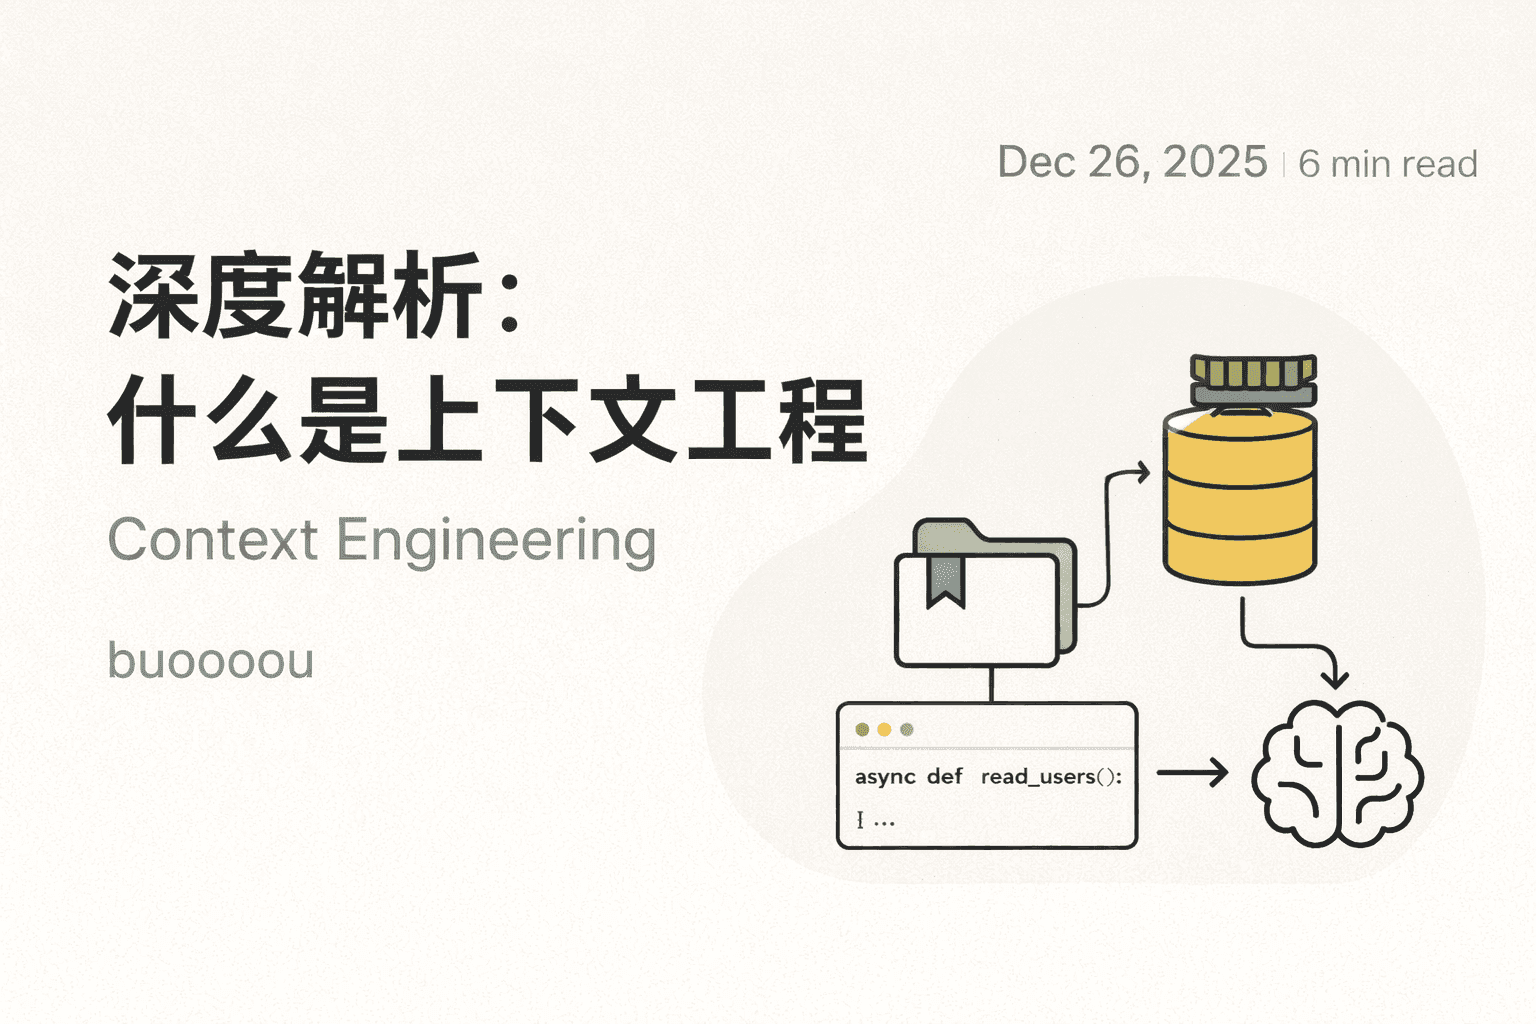
长上下文(Long Context) = 内存(RAM)。是大模型一次性吞吐、处理当前信息的“工作台”。
长期记忆(Long-Term Memory) = 硬盘(Hard Drive)。是Agent跨会话、跨越时间线持续存储信息的“仓库”。
1. 核心区别与联系
维度 | 长上下文 (Long Context) | 长期记忆 (Long-Term Memory) |
本质 | 模型层的物理限制(如128K, 1M Tokens)。 | 系统层的架构设计(结合数据库、检索策略)。 |
容量 | 有限的。目前最强如Gemini 1.5 Pro可达2M,但终有上限。 | 无限的。取决于你的数据库硬盘有多大。 |
成本 | 极高。每次对话,长上下文里的所有字数都要重新计费(Token消耗)。 | 极低。存在数据库里不花钱,只有检索出的几句话送给大模型时才计费。 |
速度 | 慢。首字响应时间(TTFT)随上下文长度增加而显著变慢。 | 快。检索毫秒级,且只送少量文本给模型,生成极快。 |
生命周期 | 单次会话有效。关掉对话框或清空上下文,模型瞬间失忆。 | 永久有效。跨会话、跨天、跨年存在。 |
两者的联系(如何打配合):
它们是互补关系。长期记忆系统负责从“无限的硬盘”里找出当前最相关的几页纸,然后把这几页纸放进大模型的“长上下文工作台”里,让大模型进行阅读和回答。
如果没有长上下文,找出来的记忆放不下;如果没有长期记忆,长上下文再大也会被无用的聊天记录塞满并破产。
2. 分别是怎么实现的?
长上下文的实现(炼丹/算法层面):
这是大模型厂商(如OpenAI, 谷歌, 智谱)做的事。通过改进注意力机制(如Ring Attention、Sparse Attention)、位置编码扩展(RoPE缩放)、或者使用非Transformer架构(如Mamba、SSM结构)来实现。长期记忆的实现(工程/系统层面):
这是Agent开发者做的事。通过外挂数据库(向量/图/关系型)、设计记忆读写逻辑(RAG体系)、以及使用工具调用(Tool Calling)让大模型自己管理记忆。
二、业界顶级 Agent 的长期记忆架构剖析
案例 1:MemGPT —— 操作系统式的分层记忆 (目前开源界的标杆)
MemGPT 的核心思想是把 LLM 当作 CPU,把记忆当作操作系统的内存管理机制。
实现机制:
它将记忆分为两层,并赋予大模型主动读写的权力。
Core Memory(核心记忆 / 类似RAM):
永远保持在上下文窗口中。分为两部分:Persona:Agent 的人设(我是谁,我该怎么做)。
Human:关于用户的核心画像(用户叫什么,职业是什么,核心偏好)。
Archival Memory & Recall Memory(归档与回忆 / 类似硬盘):
存在向量数据库中。包含所有的历史对话记录和外挂文档。主动管理(灵魂所在):
MemGPT 给大模型提供了几个函数工具(Functions),比如 core_memory_append(添加核心记忆), archival_memory_search(搜索旧记忆)。
当模型发现上下文快满了,或者用户说了重要信息时,模型会主动调用工具,把信息写进硬盘,或者从硬盘搜出来放进工作台。它不是被动的 RAG,而是主动的记忆管理。
案例 2:ChatGPT 的 Memory 功能 —— 结构化用户画像 (商业级标杆)
如果你用过 ChatGPT Plus,会发现它现在能记住你的偏好。它的做法非常精细,为了避免向量库的“幻觉”,它采用了实体抽取与结构化存储。
实现机制:
后台异步提取:当你和 ChatGPT 聊天时,后台有一个较小的模型专门在“旁听”。当你说“我今天领养了一只猫叫旺财”时,旁听模型会判断这是一条值得记忆的实体信息。
更新知识图谱/JSON:它不会把原话存入向量库,而是提取成结构化数据(User Profile)。
{"宠物": [{"种类": "猫", "名字": "旺财", "时间": "2024"}]}精准注入:下次你开启新对话时,ChatGPT 会直接把这个精炼的 JSON 偷偷放在 System Prompt 里。因为是结构化数据,所以极度精准,不会出现把“你讨厌苹果”记成“你喜欢苹果”的低级错误。
案例 3:Devin / AutoGPT —— 面向任务的“反思记忆” (Reflexion Memory)
对于写代码或执行复杂任务的 Agent,记忆不是用来聊天的,而是用来避免重复犯错的。
实现机制:
短期执行记录(Scratchpad):记录当前任务尝试的每一个步骤。
长期经验库(Experience/Reflexion DB):当 Devin 遇到一个报错,尝试了 3 种方法终于解决后,它会生成一段反思(Reflection):“当遇到 X 报错时,不要尝试方法 A,直接用方法 B 修改配置文件”。
向量+意图检索:下次 Devin 遇到类似的报错日志时,它会拿着报错日志去经验库里做向量检索,提取出以前的“避坑指南”。这是机器人的“肌肉记忆”。
案例 4:基于 GraphRAG 的高级推理 Agent (微软提出,目前最前沿)
向量数据库的致命弱点是无法进行全局推理。比如记忆A写了“张三的师傅是李四”,记忆B写了“李四的仇人是王五”。单纯问向量库“张三遇到王五该怎么办”,向量库可能找不出关系。
实现机制:
构建知识图谱(Knowledge Graph):把每次对话的人、事、物抽取为节点和连线。
GraphRAG 检索:先通过向量检索找到起始节点(张三),然后沿着图数据库的边(连线),把相关的拓扑结构全部拉出来(张三 -> 师傅 -> 李四 -> 仇人 -> 王五),打包给大模型。
这种Agent具备极其可怕的全局长线关联能力,是目前法律咨询、金融研报类顶级Agent的标配。
三、 总结:如果现在要做一个优秀的 Agent,该怎么做?
综合业界的最佳实践,目前最成熟的长期记忆架构是 “混合记忆架构 (Hybrid Memory)”。建议采用以下分层策略:
极短期(滑动窗口):最近 5-10 轮对话的原文,直接放在 Context 里。
核心事实(结构化/关系型数据库):利用大模型提取用户的固定特征(姓名、公司、过敏史、偏好),存成 JSON/SQL。每次对话无条件注入 System Prompt。
历史聊天(向量数据库):把长篇大论的聊天记录切块存入向量库。采用多路召回策略(向量相似度 + 时间衰减)。最近发生的记忆权重更高。
记忆摘要(定期压缩):每天晚上跑一次批处理,把今天的长对话总结成一两段话(Summary),存入另一个维度的数据库。回答宏观问题时(如“我上周都在忙什么”),检索摘要而不是细节。
最重要的理念转变:不要把记忆做成单向的流水线,要像 MemGPT 那样,把记忆的增删改查(CRUD)封装成工具(Tools),让大模型自己决定什么时候去记、什么时候去查、什么时候去遗忘。这才是 Agent 具备真正“自主性”的标志。
Comments (0)