
AI大模型长上下文的实现原理,并结合公开信息,探讨 Gemini 是如何实现这一突破的
深入探讨AI大模型长上下文原理,揭秘Gemini 1.5 Pro如何突破1M+ Token限制,实现“过目不忘”的惊人能力。剖析Transformer架构与自注意力机制的计算挑战与工程突围。
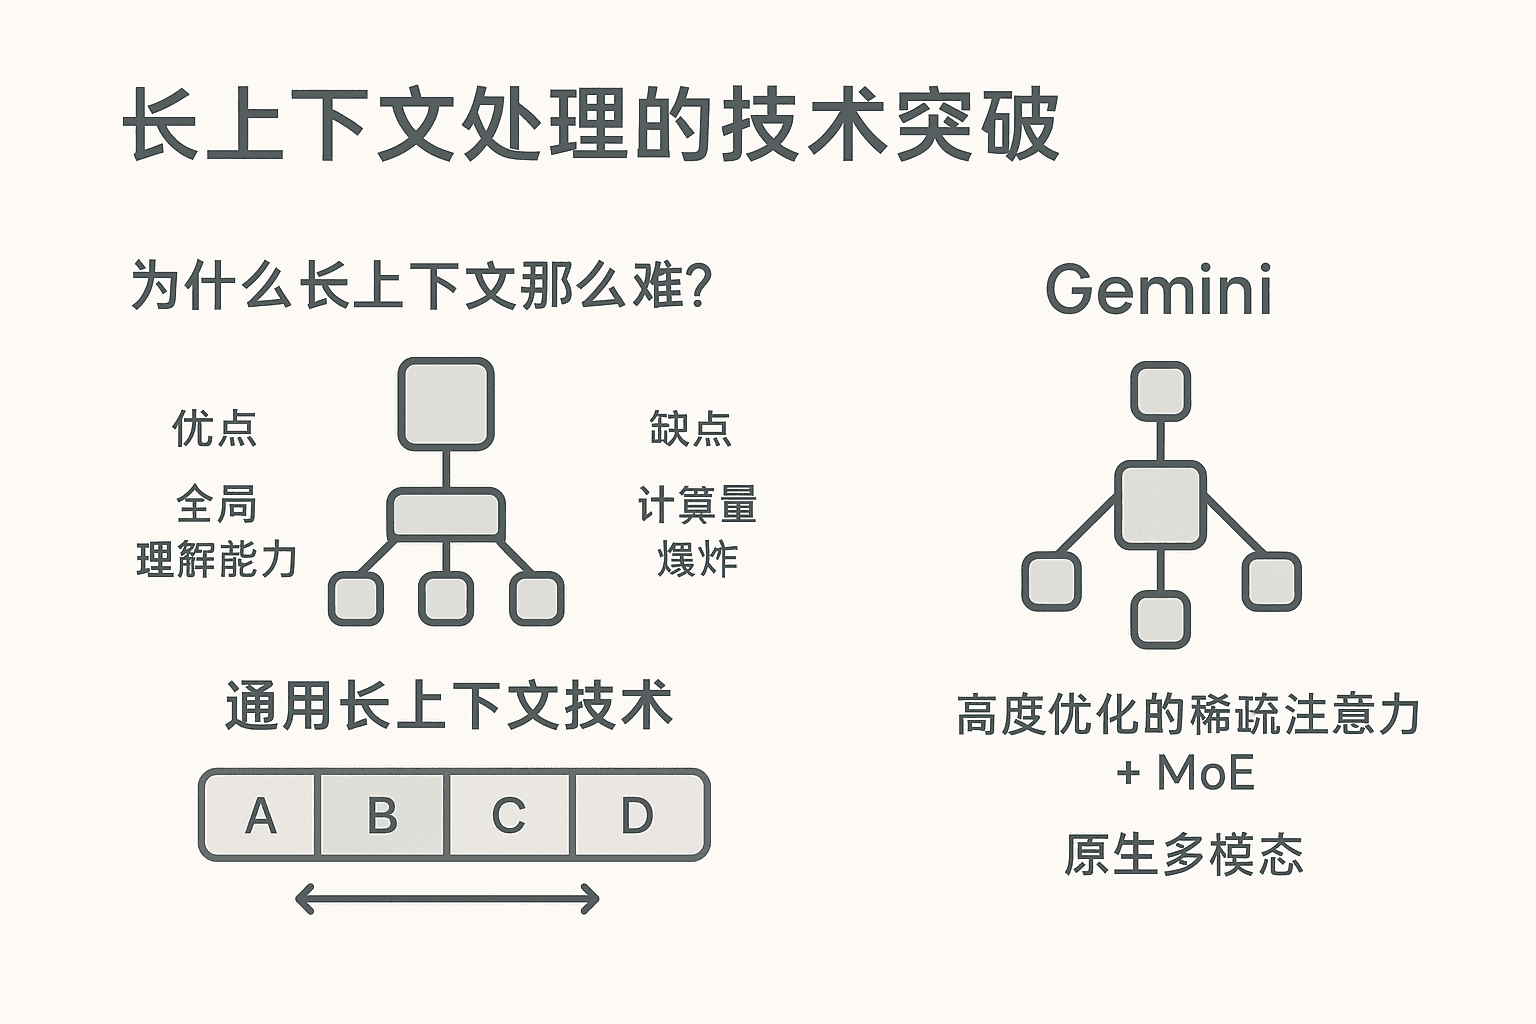
在当今的大模型(LLM)竞赛中,“上下文窗口(Context Window)”的长度已成为衡量模型推理能力的关键指标。从早期的 4k、8k 到如今 Gemini 1.5 Pro 的 1M+(甚至 10M)Token,这一跨越不仅仅是数字的堆叠,更是对底层计算架构和显存管理机制的根本性重构。
要理解 Gemini 为何能“过目不忘”,我们需要深入 LLM 的心脏——Transformer 架构,剖析其面临的数学诅咒与工程突围。
第一部分:计算复杂度的物理墙——为何长上下文曾是奢望?
Transformer 架构的核心是 自注意力机制(Self-Attention),其数学本质决定了处理长序列的先天缺陷。
1. 二次复杂度(Quadratic Complexity)的诅咒
自注意力机制要求序列中的每一个 Token 都要计算与所有其他 Token 的相关性(Attention Score)。
公式化描述为:
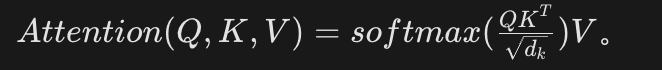
这就产生了一个N×N的注意力矩阵(Attention Matrix)。
计算量爆炸:当序列长度N翻倍,计算量增长 4 倍。处理 100k 级别的 Token,意味着百亿级别的浮点运算。
显存墙(Memory Wall):这不仅是计算速度的问题,更是存储的问题。除了注意力矩阵,KV Cache(键值缓存) 的显存占用也随序列长度线性(甚至超线性)增长。当N达到百万级,单张顶级 GPU(如 H100)的 HBM(高带宽内存)瞬间就会被击穿。
简而言之,传统 Transformer 在长上下文面前,面临着计算延迟过高和显存溢出(OOM)的双重物理极限。
第二部分:范式转移——学术界的突围策略
为了打破物理墙,AI 社区经历了从“近似计算”到“架构重构”的演进路径。
1. 稀疏化(Sparsification):从全连接到“小世界网络”
核心逻辑是:并非所有的 Token 之间都需要建立强连接。
滑动窗口(Sliding Window): 仅计算局部邻域(如前后 512 个 Token)。这将复杂度降至O(N×W)。虽然降低了开销,但导致了**感受野(Receptive Field)**受限,无法捕捉长距离依赖。
稀疏注意力(Sparse Attention / BigBird): 结合了滑动窗口、随机采样和全局节点(Global Tokens)。基于图论中的“小世界网络”理论,证明了只需少量的全局连接,就能以O(N)的复杂度逼近全注意力的效果。
2. 线性化(Linearization):状态空间模型(SSM)
以 Mamba 为代表的 SSM 架构试图彻底抛弃注意力矩阵。
原理: 类似于循环神经网络(RNN),模型维护一个压缩的隐状态(Hidden State)。在推理时,新 Token 仅与当前状态交互并更新状态,无需回顾历史数据。
优势: 推理时的内存占用恒定,计算复杂度为严格的线性O(N)。
局限: 这种有损压缩在处理“大海捞针(Needle in a Haystack)”类任务时,精度往往不如 Transformer。
3. 外挂式记忆:检索增强生成(RAG)
RAG 是一种工程上的妥协,而非模型能力的本质提升。
机制: 将长文本切片向量化(Embedding)存入向量数据库。模型推理时,先检索(Retrieve)相关片段,再利用上下文学习(In-Context Learning)生成答案。
痛点: 存在“中间迷失(Lost in the Middle)”现象,且无法进行跨片段的全局推理(Global Reasoning)。例如“总结全文的主旨变化”,RAG 往往束手无策。
第三部分:解密 Gemini 1.5 Pro——如何工程化实现百万级上下文?
Google DeepMind 虽未公开 Gemini 的完整白皮书,但结合其技术报告(Technical Report)及同期发表的学术论文(如 Ring Attention, MoE),我们可以构建出其技术栈的拼图。Gemini 的成功并非单一技术的突破,而是分布式系统、模型架构与训练算法的综合胜利。
1. 核心底座:混合专家模型(Mixture-of-Experts, MoE)
Gemini 是一个典型的稀疏 MoE 模型。这是实现长上下文高效推理的前提。
条件计算(Conditional Computation): 与密集模型(Dense Model)不同,MoE 针对每个 Token 仅激活一小部分参数(Active Parameters)。
长上下文的意义: 当处理 1M Token 时,如果使用全参数模型,计算延迟将无法接受。MoE 使得模型在参数总量(Total Parameters)极大(保证知识广度)的同时,单次推理的计算量极小(保证速度),从而为处理超长序列腾出了算力空间。
2. 分布式注意力机制:Ring Attention(关键推测)
如何在有限的 GPU/TPU 显存中放下 1M+ 的上下文?极有可能是采用了类似 Ring Attention 的技术。
原理: 传统的注意力计算需要在一张卡上存下完整的Q,K,V。Ring Attention 将序列切分,分布在多张 TPU 芯片上构成一个环。计算过程中,GPU 之间像接力棒一样传递K,V数据块。
突破: 这使得上下文长度不再受限于单卡的显存大小,而是受限于集群的总显存。理论上,只要堆叠足够的 TPU,上下文长度可以无限扩展。这解释了 Google 为何能轻松处理 1M 甚至 10M Token。
3. 位置编码的进化:RoPE 与外推性
Transformer 需要位置编码(Positional Encoding)来感知 Token 的顺序。
RoPE(旋转位置编码): Gemini 极大概率使用了 RoPE 的变体。它通过数学上的旋转操作,赋予了模型更好的外推性(Extrapolation)。即:即使训练时只见过 32k 的长度,通过调整 RoPE 的基频(Base Frequency),模型也能在推理时泛化到 1M 长度,且保持性能不衰减。
4. 原生多模态(Native Multimodality)与统一语义空间
Gemini 不是简单的“文本模型+视觉编码器”,而是从头开始训练的原生多模态模型。
交错序列(Interleaved Sequences): 视频、音频被 Token 化(Tokenized)后,直接映射到与文本相同的向量空间。
长程多模态依赖: 这意味着模型利用长上下文能力,不仅是在“读”字,而是在时间维度上对视频帧进行关联分析。例如,它可以回忆起 1 小时视频中第 3 分钟的一个微小动作,并与第 50 分钟的结局建立逻辑联系。这种能力是 RAG 无法比拟的。
总结:AI 记忆的终极形态
Gemini 的技术实现可以总结为一套精密的组合拳:
Ring Attention(打破显存墙) + MoE 架构(保证推理速度) + RoPE 变体(解决位置泛化) + 原生多模态(统一信息表征)
这一突破标志着 LLM 从“无状态(Stateless)”或“短记忆”时代,正式跨入**“无限上下文(Infinite Context)”**时代。模型不再需要通过 RAG 这种“开卷考试”的方式来间接获取信息,而是能够真正地将整本书、整部电影“装进大脑”,进行端到端的全局推理。这是通往 AGI(通用人工智能)道路上,关于“记忆与理解”的最重要的一块拼图。
Comments (0)